Cassandra データモデル入門 — AP 選択の帰結としてのマスターレス分散 DB
CAP 定理で AP を選んだ結果としての Cassandra アーキテクチャ。マスターレスのゴシップ通信、パーティション分散、レプリケーション戦略、ACID ではなく AID という表現までを RDBMS 比較で整理。
Cassandra が解く問題
Cassandra は 「地理分散した大量書き込み + 単一障害点なし」 を最優先する環境のための分散 NoSQL です。
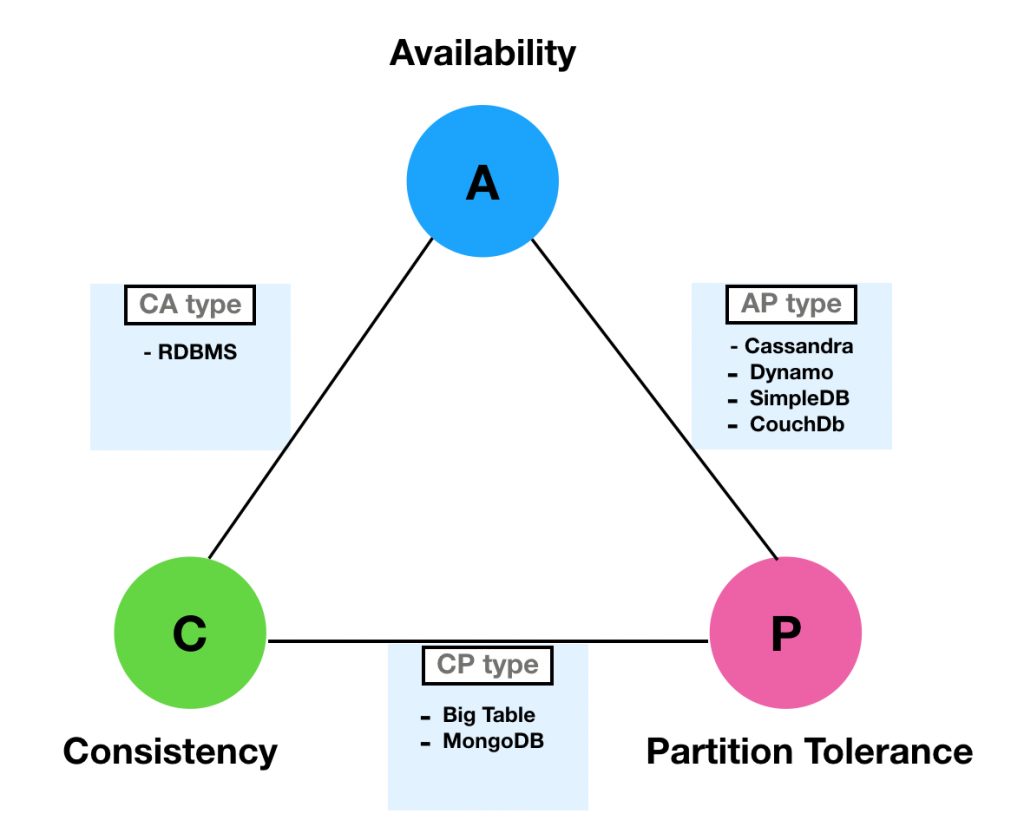
CAP 定理 (Consistency / Availability / Partition tolerance の 3 要素のうち 2 つしか満たせない) で言えば、Cassandra は AP を選択しています:
- 強整合性 (Consistency) より 可用性 (Availability) を優先
- ノード間ネットワーク分断 (Partition tolerance) 下でも書き込みを受け付ける
そのため金融系の取引台帳のような強整合が要るワークロードよりも、 IoT センサーデータ、イベントログ、タイムシリーズ、メッセージング履歴 のような 「書き込み多数で許容レイテンシが低い」 ユースケースに向いています。
RDBMS との思想差
| RDBMS (PostgreSQL / MySQL) | Cassandra | |
|---|---|---|
| トポロジ | シングルプライマリ (+ 読み取りレプリカ) | 完全マスターレス (すべてのノードが対等) |
| 書き込みスケール | 1 プライマリがボトルネック、Sharding で分散 | ノード追加 = 書き込みスループット比例増 |
| データモデル | 正規化 → JOIN | 非正規化 (クエリ単位にテーブル設計) |
| トランザクション | ACID (マルチテーブル) | 単一パーティション内のみ (AID) |
| 一貫性 | 強整合 | 調整可能 (ONE/QUORUM/ALL … 一貫性レベル 参照) |
| スケール単位 | スケールアップ中心 | スケールアウトが前提 |
| SPOF | プライマリ | 無し (各ノードが平等) |
注意: 2017 当時の 「RDBMS は大規模データに未対応」 という表現は誇張で、現代の PostgreSQL / Aurora / CockroachDB などは数 TB 規模のデータや分散構成を扱えます。Cassandra が本当に勝つのは グローバル分散 + 書き込み多数 の領域です。
マスターレスアーキテクチャの中身
リング構造とパーティショニング
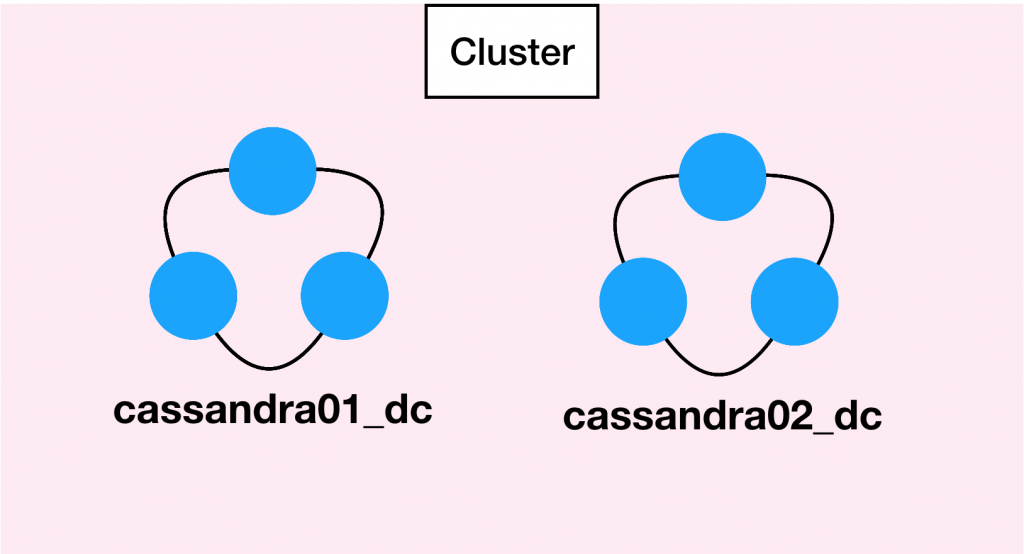
Cassandra のクラスタは リング (ハッシュ空間) で表現されます。
主キーの一部 (パーティションキー) をハッシュ化して、どのノードに格納するかを決定します。
デフォルトは Murmur3Partitioner で、ハッシュ空間を全ノードで分割所有します。
ゴシップ通信
ノード間は ゴシッププロトコル で状態を伝播し合います:
- 自分の状態 (負荷、持っているデータ範囲、生存情報) を 1 秒毎に数ノードに送る
- 受け取った側は差分をマージしてさらに広める
これにより、どのノードが落ちたか / 新しく参加したか が数秒で全体に伝わります。
ただし起動時にクラスタの情報を得るための Seed ノード だけは例外。 Seed は 「最初の connectivity を与える」 役割なので、本番では複数設定・DC ごとに最低 2 台が推奨です。
物理 DC + 仮想 DC
Cassandra は複数の物理データセンターでクラスタを組めます。 さらに論理的な 「仮想 DC」 (バッチ用・リアルタイム用を分ける等) を定義することで、 ワークロードを物理的に分離 できます。
レプリケーション戦略
SimpleStrategy
単一データセンター前提のシンプルなポリシー。 検証・単一リージョンの限られた用途向け 。本番用途ではまず使いません。
NetworkTopologyStrategy
複数 DC / 複数 Rack 対応。本番では常にこれを選ぶ 。 将来 DC を増やす可能性があるなら、単 DC でも最初からこれで始めます。
キースペース作成時に RF (Replication Factor) を DC 毎に指定:
CREATE KEYSPACE app_data WITH replication = {
  'class': 'NetworkTopologyStrategy',
  'ap_northeast_1': 3,
  'us_east_1': 3
};
東京 3 レプリカ + バージニア 3 レプリカ = 全 6 レプリカ、 地理分散で耐 DR 性を上げる典型。
読み書きが速い理由
| 書き込みパス | 詳細 |
|---|---|
| 1. CommitLog に追記 | 永続化保証 (順次書き込みで高速) |
| 2. MemTable に書き込み | インメモリ構造、超高速 |
| 3. 一定条件で Flush → SSTable | ディスクに不変ファイルとして書き出し |
| 4. Compaction で SSTable をマージ | 削除 (Tombstone) や重複を整理 |
詳細は Cassandra データ処理フロー に。
トランザクションは 「AID」
Cassandra はマルチテーブル・マルチパーティションの ACID を提供しません。 しかし 単一パーティション内では AID (Atomicity / Isolation / Durability) を保証します。
- Atomicity: 1 行への複数カラム書き込みは全部成功か全部失敗- Isolation: 単一行への書き込みは他リクエストから中途半端に見えない- Durability: CommitLog と Hinted Handoff で永続性を担保強整合 が要る箇所だけ、書き込み/読み込み時に
QUORUM/ALLなどの一貫性レベルを指定 (後続記事参照)。## 2017 → 現代の変化| 当時 | 現代 | | --- | --- | | Apache Cassandra 3.x | 4.1 / 5.0 (2024+) | | Thrift API サポート | 廃止 (5.x で完全削除)、CQL のみ | | Materialized View (実験的) | 本番非推奨のまま、手動 denormalization 推奨 | | JVM 8 | JVM 11/17 推奨 (JVM 21 も段階的対応) | | MapReduce 統合 | Spark Connector が事実上の分析経路 | | 競合 | ScyllaDB (C++ 実装、同プロトコル互換、数倍高速) が本格台頭 |
マネージドサービスでは Amazon Keyspaces、DataStax Astra DB が代表的で、 自前クラスタ運用の重さから解放されます。
まとめ
Cassandra を選ぶかどうかの判断軸はシンプル:
- 書き込みのスケーラビリティ + 可用性最優先 → Cassandra
- 強整合トランザクション + 複雑なクエリ → RDBMS (または CockroachDB / Spanner 系)
- 時系列 + 高カーディナリティ → InfluxDB / TimescaleDB / VictoriaMetrics
- ドキュメント志向 + 柔軟スキーマ → MongoDB
「分散だから速い」 ではなく、「書き込みと可用性のためなら整合性を調整する覚悟」 を持てるかどうかが Cassandra の採用判断です。
関連記事
 クラウド·
Cassandra 読み書きの内部フロー — MemTable / SSTable / Compaction を追う
Cassandra の Read と Write がどのメモリ・ディスク構造を通るのかをステップで解剖。Bloom Filter・Partition Index・Row Cache・Tombstone・Compaction 戦略の使い分けまで。
 クラウド·
Cassandra マルチノードクラスタ構築手順 — Seed / Snitch / DC 設計の勘所
シングルノードから Cassandra マルチノードクラスタへ拡張する手順。GossipingPropertyFileSnitch への切り替え、Seed ノードの意味、起動順、nodetool status の読み方まで本番運用を想定した設計指針つき。
 クラウド·
Cassandra 一貫性レベルの選び方 — ONE から ALL まで、現場で何を使うか
Cassandra の Tunable Consistency を Read/Write 別に整理。QUORUM の数式、R+W>RF の原則、マルチ DC での LOCAL_QUORUM 推奨、トレードオフの実例つき。