Cassandra マルチノードクラスタ構築手順 — Seed / Snitch / DC 設計の勘所
シングルノードから Cassandra マルチノードクラスタへ拡張する手順。GossipingPropertyFileSnitch への切り替え、Seed ノードの意味、起動順、nodetool status の読み方まで本番運用を想定した設計指針つき。
本記事で得られること
シングルノード構築 ができている前提で、 複数ノードを 1 つのリングに参加させてクラスタを組む手順を解説します。 焦点は手順そのものより、各設定項目が本番運用で何に効くのか にあります。
前提: Cassandra データモデル入門 と Cassandra 読み書き内部フロー を把握している。
クラスタ構成の最小単位
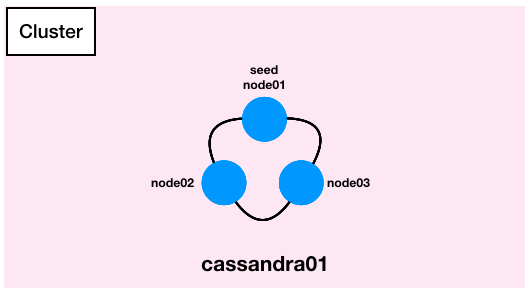
本稿では 3 ノード (DC1 / Rack1) を想定。 本番の推奨は以下:
- 1 DC 最低 3 ノード (RF=3 で QUORUM が成立する最小)
- マルチ DC 構成 (地理分散 + DR)
- 各 Rack にノードを分散配置 (Rack 障害への耐性)
全ノード共通の cassandra.yaml
cluster_name: 'glv-prod'

listen_address: <自ノードの IP>
rpc_address:    <自ノードの IP>

endpoint_snitch: GossipingPropertyFileSnitch   # 本番必須

seed_provider:
  - class_name: org.apache.cassandra.locator.SimpleSeedProvider
    parameters:
      - seeds: "10.0.0.10,10.0.0.11"           # Seed 2+ ノードを列挙
Seed ノードとは
Seed は 新しく参加するノードが最初にコンタクトする 「問い合わせ先」 です。 Seed から「クラスタに今どのノードがいるか」を学び、全ノードとゴシップ通信を開始します。
本番の Seed 設計の鉄則:
- DC ごとに最低 2 ノードを Seed に指定 (1 台しかないと Seed が落ちた時に新規参加不可)- Seed ノード自身も通常の Cassandra ノードとして動作する (特別扱いされない)
- Seed リストは 全ノードで完全に一致 させる
Seed の数が多すぎると起動時のゴシップが増えるので、DC あたり 2〜3 が目安。
Snitch を本番用に切り替える
endpoint_snitch を GossipingPropertyFileSnitch にすると、
各ノードが cassandra-rackdc.properties の DC/Rack 設定をゴシップで伝播するようになります。
他の Snitch:
| Snitch | 用途 |
|---|---|
SimpleSnitch | 単 DC 検証用、本番非推奨 |
GossipingPropertyFileSnitch | 本番の既定 (DC/Rack を手動定義) |
Ec2Snitch | AWS 単リージョン自動検出 |
Ec2MultiRegionSnitch | AWS マルチリージョン自動検出 |
GoogleCloudSnitch / CloudstackSnitch | GCP / CloudStack 自動検出 |
AWS / GCP ではクラウド固有の Snitch を使うと DC/Rack の設定が自動化できます。
自前データセンタや混在環境では GossipingPropertyFileSnitch。
DC / Rack の設定
/etc/cassandra/cassandra-rackdc.properties:
dc=ap-northeast-1       # 物理 DC またはリージョン
rack=ap-northeast-1a    # AZ またはラック
Rack を分散させる意味: Cassandra は同一 Rack 内に同じキーの全レプリカを置かないように配置します (NetworkTopologyStrategy)。
AZ をまたがせることで Rack / AZ 障害でもデータ損失ゼロ を担保。
マルチ DC の例:
| Node | DC | Rack |
|---|---|---|
| 10.0.0.10 | ap-northeast-1 | ap-northeast-1a |
| 10.0.0.11 | ap-northeast-1 | ap-northeast-1c |
| 10.0.0.12 | ap-northeast-1 | ap-northeast-1d |
| 10.0.1.10 | us-east-1 | us-east-1a |
| … | … | … |
起動順序
Seed ノードから先に起動 → 他ノードが Seed にコンタクトして参加、が原則。
# Seed ノード (10.0.0.10, 10.0.0.11)
sudo systemctl start cassandra
sleep 60   # 起動完了まで待つ
nodetool status

# 残りのノード
sudo systemctl start cassandra同時起動は避ける。concurrent_joining 回避のため、
1 ノード参加完了 → 次ノードを参加、という 逐次流れ にしましょう。
nodetool status での確認
nodetool statusDatacenter: ap-northeast-1
==========================
Status=Up/Down
|/ State=Normal/Leaving/Joining/Moving
-- Address Load Tokens Owns (effective) Host ID Rack
UN 10.0.0.10 282 KiB 256 66.7% a1c9c548-... ap-northeast-1a
UN 10.0.0.11 200 KiB 256 66.7% lgojru90-... ap-northeast-1c
UN 10.0.0.12 320 KiB 256 66.7% jgjigio0-... ap-northeast-1dチェックポイント:
- 全ノードが
UN(Up & Normal) か Rackが意図通り分散されているかOwnsの合計がおよそ 100% (RF 設定を反映した割合) か
キースペースを NetworkTopologyStrategy で作成
本番で SimpleStrategy を使わない (将来マルチ DC に移行できない):
CREATE KEYSPACE app WITH replication = {
  'class': 'NetworkTopologyStrategy',
  'ap-northeast-1': 3
};

ALTER KEYSPACE system_auth WITH replication = {
  'class': 'NetworkTopologyStrategy',
  'ap-northeast-1': 3
};
システムキースペースも NetworkTopologyStrategy に する必要があります。
認証情報 (system_auth) を SimpleStrategy で作ってあると、1 ノード障害で認証そのものが落ちる事故に直結。
マルチ DC への拡張
既存の DC1 に DC2 を追加する流れ:
- DC2 側のノードに同じ
cluster_name+ 新しいdcを設定 - Seed に DC2 の代表ノードも追加 (両 DC のノードで同一リスト)
- ノード逐次起動
- 既存キースペースを
ALTERして DC2 にもレプリカ配置:ALTER KEYSPACE app WITH replication = { 'class': 'NetworkTopologyStrategy', 'ap-northeast-1': 3, 'us-east-1': 3 }; - 新 DC への同期:
(us-east-1 側のノードで実行し、ap-northeast-1 からデータをコピー)nodetool rebuild ap-northeast-1
落とし穴
1. cluster_name を途中で変える
クラスタ名を変えると既存ノードは参加拒否されます。最初に決めた名前を守る。
2. Seed ノードの IP を変更して全ノード更新忘れ
Seed リストが一致しないとゴシップ通信がうまく成立しないことがあります。 IP を変える場合は 一度に全ノードで 設定を揃える。
3. nodetool decommission せずに IP を変更
ノードの IP を変える時は、必ず decommission → 停止 → 設定変更 → 起動 → ブートストラップ、の手順で。
勝手に IP を変えるとクラスタビューが壊れます (gossip_unreachable_members 等が永続化)。
4. Rack を均等に分散していない
RF=3 なのに全 Rack=1 だと、Rack 障害で全レプリカ消失。 Rack 数 ≥ RF が理想。難しい場合は複数 AZ を Rack として分散。
5. ノードの時刻がずれている
Cassandra は書き込みタイムスタンプを使って Last-Write-Wins するので、 時刻が大きくズレると 意図しない上書き や データ消失 の原因に。 ChronyD / NTP で全ノード時刻同期は必須 。
6. nodetool repair を忘れる
Cassandra は Eventually Consistent なので、ノード間のデータ差分を定期的に修復する必要があります。
gc_grace_seconds (既定 10 日) より短い周期で nodetool repair を実行しないと、
削除したデータが Zombie として復活します。
Reaper (http://cassandra-reaper.io/) のような repair スケジューラ導入を推奨。
2017 → 現代 (2024+)
- クラスタ運用の自動化は Cassandra Operator (K8ssandra / Cass-Operator) に任せる選択肢が成熟
- マネージドなら Amazon Keyspaces / DataStax Astra DB でクラスタ構築作業そのものが不要に
- 生のクラスタを手で立てるのは、特殊要件 (強い I/O カスタム・オンプレ厳しい要件) が無ければ非推奨
- 代替候補として ScyllaDB (C++ 実装、同じプロトコル互換、大幅に高速かつ運用楽)
まとめ: Cassandra クラスタ構築のポイントは Seed・Snitch・DC/Rack・RF・一貫性レベル の 5 つを一貫した設計で貫くこと。 手順そのものは数ステップですが、本番運用の継続性 を支えるのはこれらの設計判断です。 現代は手元で組むより マネージドか Operator に頼るほうが楽、という選択肢も検討の価値があります。
関連記事
 クラウド·
Cassandra 一貫性レベルの選び方 — ONE から ALL まで、現場で何を使うか
Cassandra の Tunable Consistency を Read/Write 別に整理。QUORUM の数式、R+W>RF の原則、マルチ DC での LOCAL_QUORUM 推奨、トレードオフの実例つき。
 クラウド·
Cassandra データモデル入門 — AP 選択の帰結としてのマスターレス分散 DB
CAP 定理で AP を選んだ結果としての Cassandra アーキテクチャ。マスターレスのゴシップ通信、パーティション分散、レプリケーション戦略、ACID ではなく AID という表現までを RDBMS 比較で整理。
 クラウド·
Cassandra 読み書きの内部フロー — MemTable / SSTable / Compaction を追う
Cassandra の Read と Write がどのメモリ・ディスク構造を通るのかをステップで解剖。Bloom Filter・Partition Index・Row Cache・Tombstone・Compaction 戦略の使い分けまで。