Cassandra 読み書きの内部フロー — MemTable / SSTable / Compaction を追う
Cassandra の Read と Write がどのメモリ・ディスク構造を通るのかをステップで解剖。Bloom Filter・Partition Index・Row Cache・Tombstone・Compaction 戦略の使い分けまで。
なぜ 「内部フロー」 を知る必要があるのか
Cassandra は上から見ると CQL でクエリを投げるだけの普通の DB に見えます。 しかし運用で遭遇する以下の問題は、内部のデータフローを知らないと原因が追えません:
- 特定キーだけ読み取りが遅い — Bloom Filter miss 多発、Partition が大きすぎる- ディスク使用量が膨らみ続ける — Compaction 戦略ミスマッチ or Tombstone 大量生成- ある瞬間だけ CPU が跳ねる — Compaction や GC 発火のタイミング- 削除直後にデータが見える — Compaction が走るまで物理的には残っている 本稿では Read / Write / Delete / Compaction の 4 フローを 1 本ずつ解剖します。 前提として Cassandra データモデル入門 を先に読んでおくと理解しやすいです。
Read フロー (読み取り)
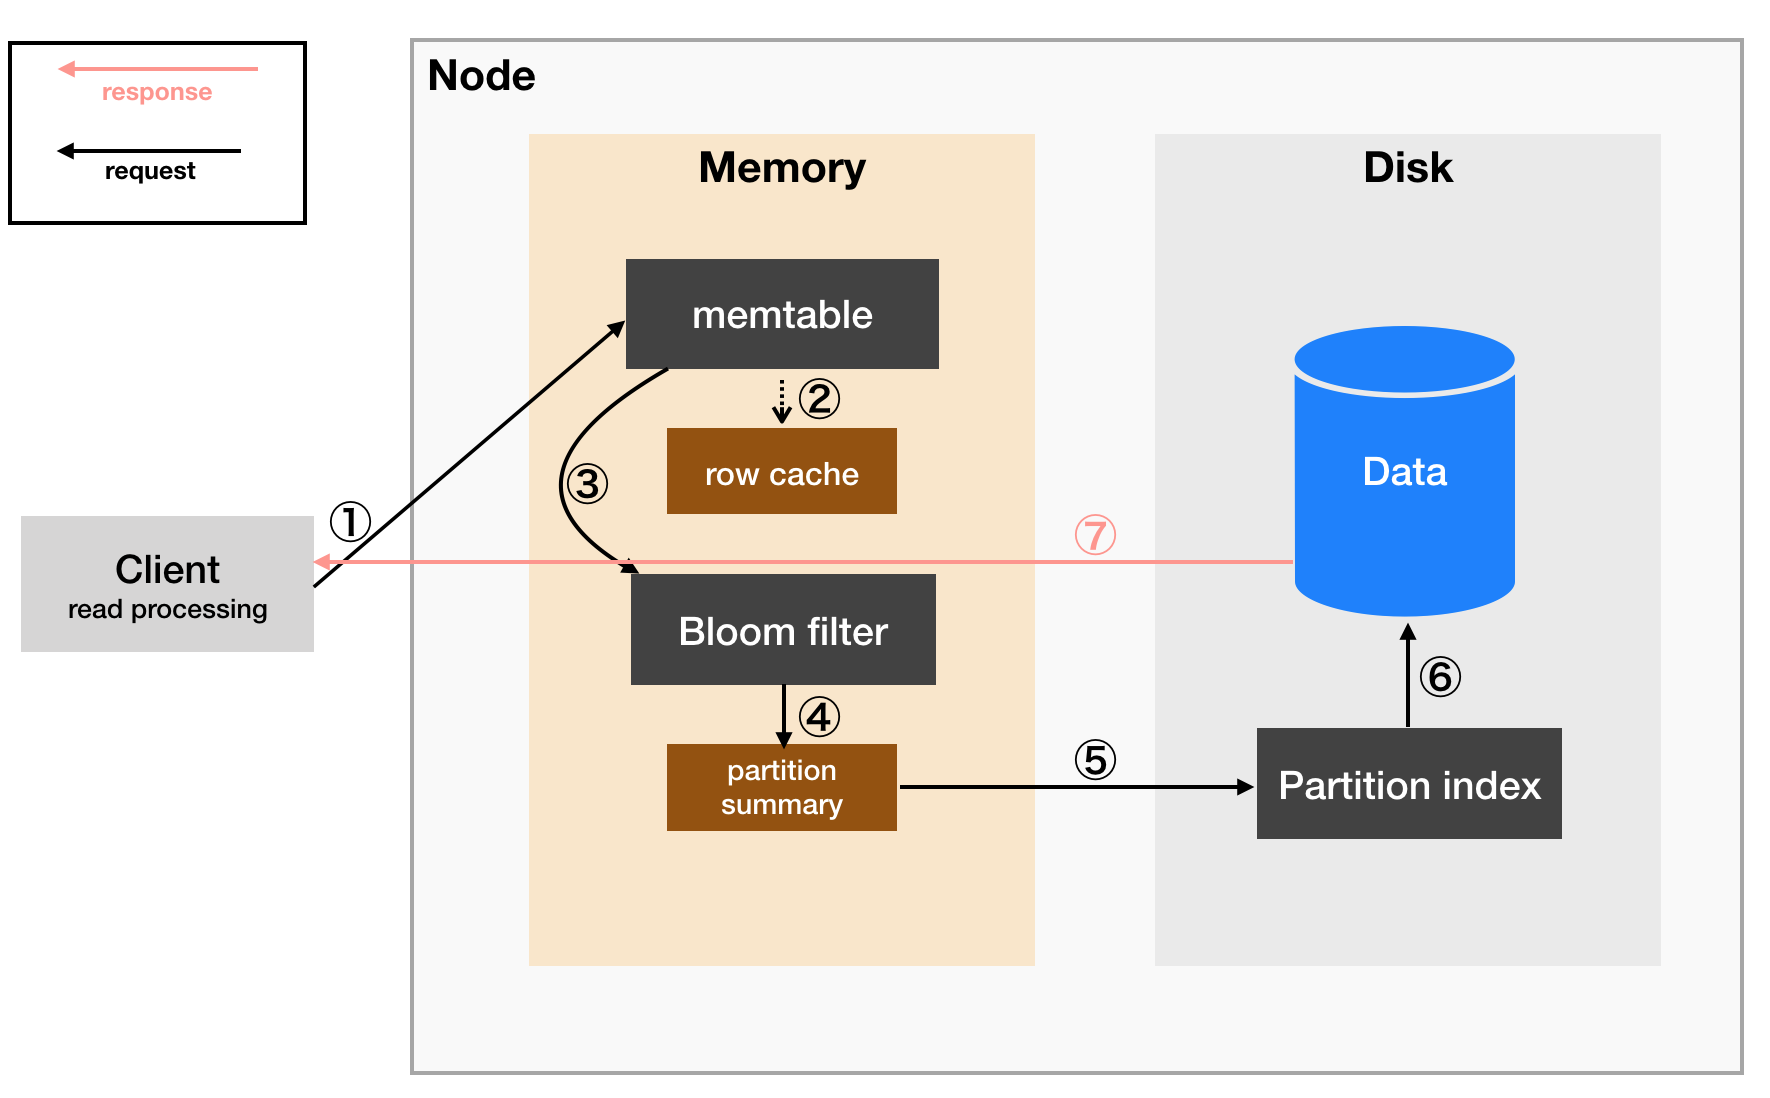
Read は 複数の格納場所を順に探しに行く のが特徴です。
Client Query
    ↓
① Row Cache (optional)  — あれば即返す
    ↓ miss
② MemTable             — まだディスクに落ちていない直近書き込み
    ↓ miss
③ Bloom Filter         — 「そもそもこの SSTable にあるか」を高速判定
    ↓ positive
④ Partition Key Cache  — Partition Index の一部をキャッシュ
    ↓ miss
⑤ Partition Index      — SSTable 内の位置特定
    ↓
⑥ SSTable (ディスク)   — 実データ読み取り
各ステップの役割
Row Cache: SSTable のデータそのものをメモリにコピー。
書き込みの少ない Hot Row にだけ有効化します。全データに効かせるとメモリを食い尽くすので、CREATE TABLE の caching オプションで Row 単位に明示設定。
MemTable: パーティションキー単位のインメモリ書き込みバッファ。 一定サイズ or 時間を越えると Flush されて SSTable 化します。
Bloom Filter: 「このキーはこの SSTable に存在しないことが確実」 を高速判定する確率的データ構造。 False Positive は許容 (後段の Partition Index で確実判定)、False Negative は起きない。 完全オフヒープ なので GC に優しい。
Partition Key Cache: Partition Index のポインタキャッシュ。 Bloom Filter が positive を返したあと、Partition Index の該当エントリをすぐ見つけるためのショートカット。
Partition Index: SSTable 内で指定 Partition がどのオフセットにあるかを示すインデックス (ディスク上)。
SSTable: 不変のソート済みファイル。 Cassandra は 既存 SSTable を書き換えない (immutable) ため、 更新は新しい SSTable に追加される → 後述の Compaction で統合される設計。
Partition が大きすぎると詰まる
1 Partition のサイズは 100MB 以下、行数 10 万以下 が公式ガイドライン。
超えると Read レイテンシが爆発し、GC や OOM の原因になります。
設計時に PRIMARY KEY((partition_key), clustering_key) の分割粒度を慎重に。
Write フロー (書き込み)
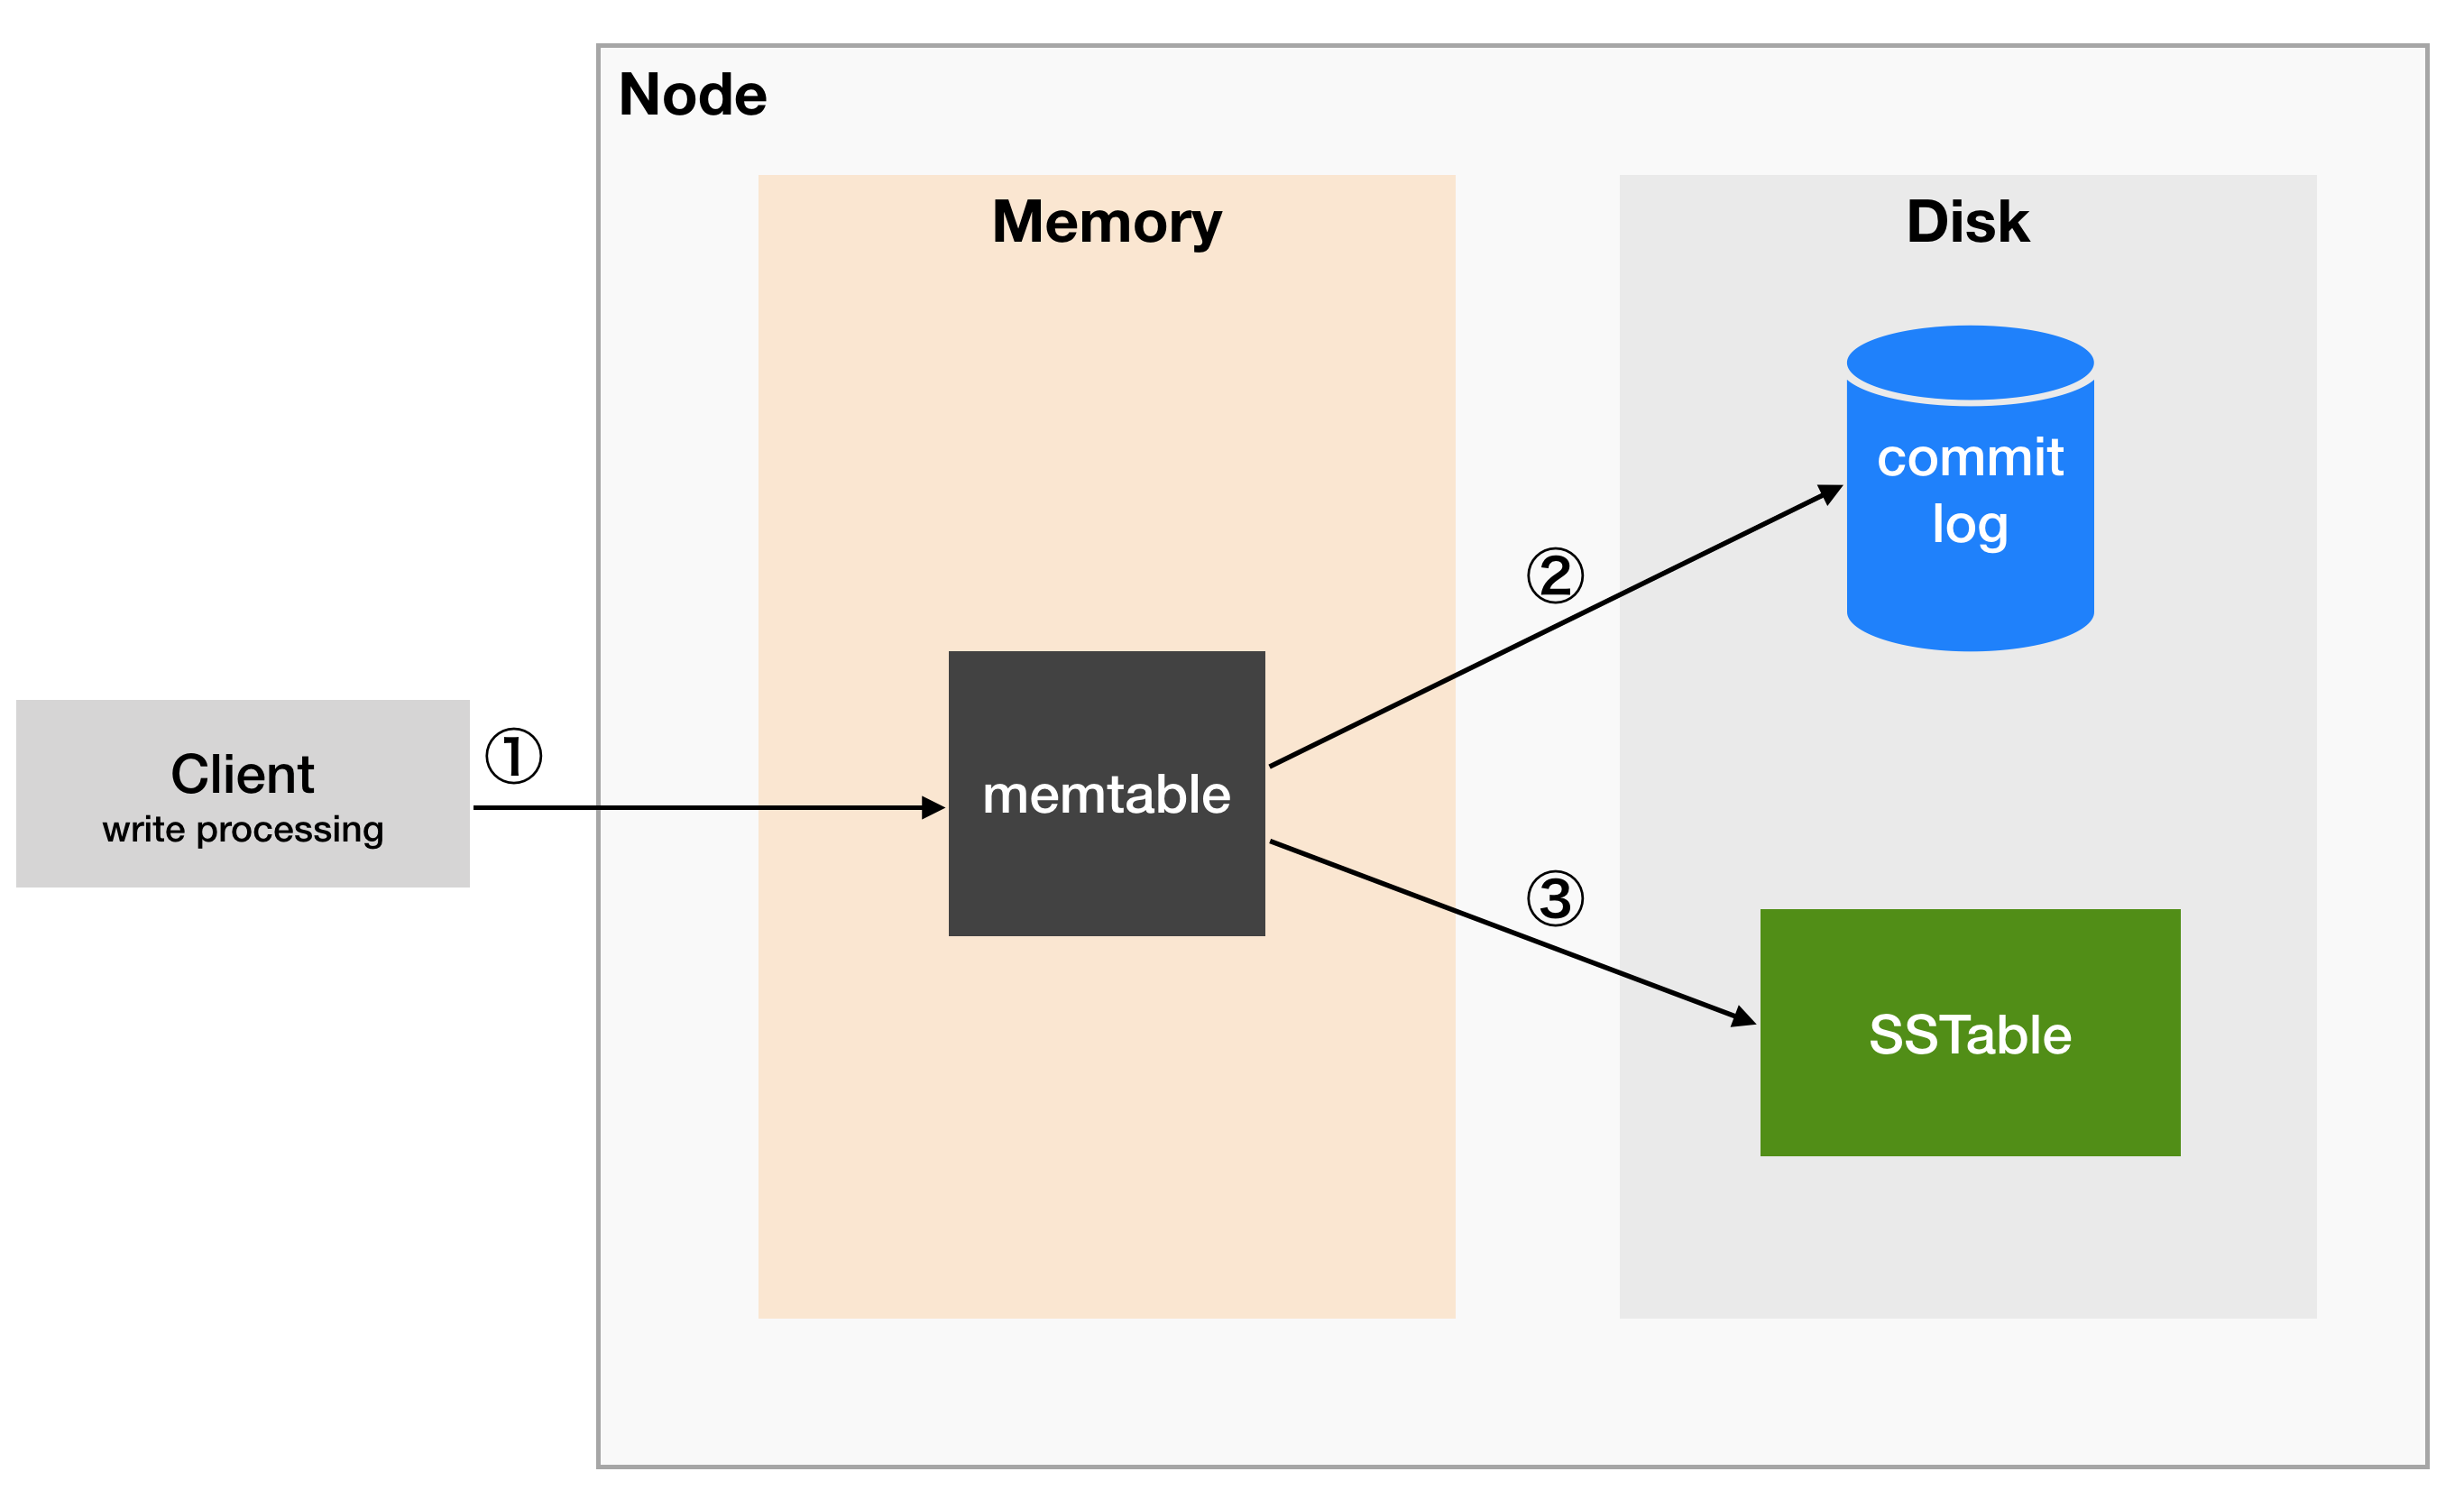
Write は Read と対照的に ほぼ常にメモリ処理 → 高速 です。
Client Write
    ↓
① Coordinator Node (RF ノードにファンアウト)
    ↓
② CommitLog に追記 (永続化保証)
    ↓
③ MemTable に書き込み (インメモリ)
    ↓
④ 閾値を超えたら Flush → SSTable 生成
ポイント: ステップ ②③ が完了すれば ACK を返せる ため、 ディスクのランダム書き込みを避けつつ永続化も担保しています (追記型 WAL パターン)。
Hinted Handoff: レプリカ先のノードが一時的に落ちている場合、 Coordinator が 「後で届ける Hint」 を一時保存し、復旧後に自動で転送します。 これにより 短時間の障害では Write が落ちない のが Cassandra 可用性の鍵。
Delete フロー (削除)
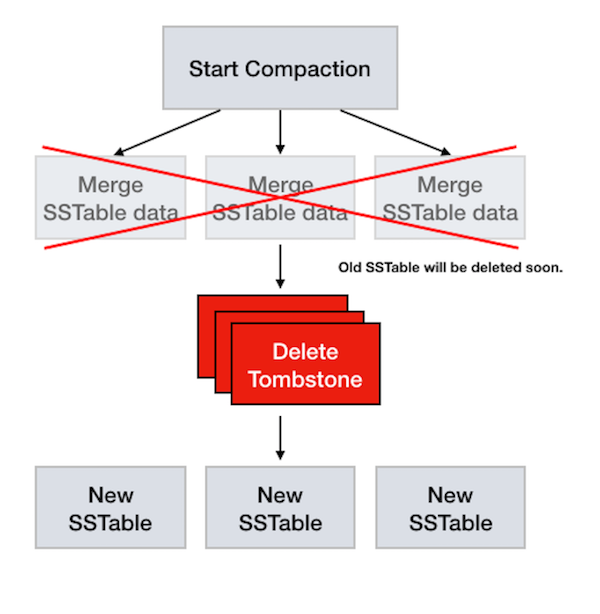
Cassandra の削除は 物理削除ではなく論理削除 です。 削除要求が来ると Tombstone (墓石) マーカーを書き込みます。
① Delete 要求
    ↓
② Tombstone を書き込み (「このキーは削除済み」のマーカー)
    ↓
③ 後続 Read は Tombstone を見て "無い" と判定
    ↓
④ gc_grace_seconds (既定 10 日) 経過後、Compaction で物理削除
なぜ 10 日も残すのか
Hinted Handoff の猶予。
もし削除直後に物理削除してしまうと、落ちていたノードが復旧して 「古い書き込み」 を送ってきた場合、
削除済みのはずのデータが復活 (= Zombie Row) してしまいます。
gc_grace_seconds は「全ノードが削除を知るまで待つ」余裕時間。
TTL も Tombstone 化する
USING TTL 86400 で 1 日後に自動削除される指定も、内部的には TTL 到達時に Tombstone 化 → Compaction で物理削除。
TTL を使う設計は、Compaction がついて来られる書き込み量か検証が必須。
Tombstone の罠
高頻度 DELETE が入るテーブル では Tombstone が SSTable に大量に残り、
Read 時のスキャンコストが爆発します。
10 万 Tombstone を越えるとクエリが非常に遅くなる事象が有名で、
対策として unchecked_tombstone_compaction を調整するか、
そもそも設計を見直す (TTL 短く、別テーブルに再配置、など)。
Compaction (SSTable 統合)
SSTable が増え続けると Read 時に見る対象が増えて遅くなるので、 定期的に Compaction で統合します。
複数の古い SSTable → マージ → 新しい SSTable
    + Tombstone が gc_grace_seconds を越えていれば物理削除
    + 重複するバージョン (更新履歴) をマージ
戦略の使い分け
| 戦略 | 向く用途 | 特徴 |
|---|---|---|
| STCS (SizeTieredCompactionStrategy) | 書き込み中心 | 同サイズの SSTable をまとめる。読み込み時に複数 SSTable を見るコスト高 |
| LCS (LeveledCompactionStrategy) | 読み込み中心 | レベル階層で管理、Read で見る SSTable 数を最小化。IO 使用量が高い |
| TWCS (TimeWindowCompactionStrategy) | 時系列 + TTL あり | 時間窓ごとに SSTable をグループ化、TTL 期限と同時に SSTable 丸ごと削除 |
| 非推奨 | TWCS に置き換わり |
時系列データは必ず TWCS を選びます。 2017 当時は DTCS が記述されていましたが、現行版 (3.0.x 以降) では TWCS が置き換え で推奨されています。
パフォーマンスを削る実務 Tips
1. 読み書きの一貫性レベルを 「適切に下げる」
Read/Write を常に ALL にしないでも、業務要件に合えば LOCAL_QUORUM で十分なことが多い。
詳細は Cassandra 一貫性レベル に。
2. SELECT * を避ける
列数が多いテーブルで * を使うと全カラム読み込みで無駄。必要なカラムだけ指定。
3. ALLOW FILTERING は実質禁じ手
パーティション全体をスキャンするため、本番ワークロードに乗せると 1 クエリで CPU 100%。 「ALLOW FILTERING を要する = モデリング失敗」 のサインとして受け止めるべき。
4. 大量 Tombstone の予防
- バッチ DELETE より TTL + TWCS
- Null 値の上書きは Tombstone 扱いになることに注意
5. nodetool compactionstats で健全性確認
Compaction が追いついているかを運用時に継続監視。
まとめ: Cassandra の Read/Write/Delete は 「追記 + 不変ファイル + 後追い統合」 という一貫したパターンで動いています。 一見複雑に見えますが、「書き込みは速く、整理は非同期」 という割り切りを知れば運用判断が明快になります。 Tombstone と Compaction は Cassandra 運用で最も事故が起きやすい領域なので、 テーブル設計時点で「どれくらい DELETE が入るか」を見積もっておきましょう。
関連記事
 クラウド·
Cassandra データモデル入門 — AP 選択の帰結としてのマスターレス分散 DB
CAP 定理で AP を選んだ結果としての Cassandra アーキテクチャ。マスターレスのゴシップ通信、パーティション分散、レプリケーション戦略、ACID ではなく AID という表現までを RDBMS 比較で整理。
 クラウド·
Cassandra 一貫性レベルの選び方 — ONE から ALL まで、現場で何を使うか
Cassandra の Tunable Consistency を Read/Write 別に整理。QUORUM の数式、R+W>RF の原則、マルチ DC での LOCAL_QUORUM 推奨、トレードオフの実例つき。
 クラウド·
Cassandra マルチノードクラスタ構築手順 — Seed / Snitch / DC 設計の勘所
シングルノードから Cassandra マルチノードクラスタへ拡張する手順。GossipingPropertyFileSnitch への切り替え、Seed ノードの意味、起動順、nodetool status の読み方まで本番運用を想定した設計指針つき。