連結リストを Java で自作する — 計算量・ArrayList との境界・現場での使いどころ
連結リストを Generics で自前実装しつつ、ArrayList との計算量・メモリ・キャッシュ効率の比較、現代の Java でこの構造を選ぶ数少ない場面を整理する。
なぜ今さら連結リストか
Java には java.util.LinkedList が既に存在し、
現場で「LinkedList を使うべき」と言える場面は実際には非常に限られています。
大半のユースケースでは ArrayList の方が速い というのが現代の経験則です
(キャッシュ局所性で CPU が味方するため)。
それでも連結リストを自作して理解することには、以下の価値があります:
- ポインタ (参照) 操作の基礎 — 多くのツリー構造・ハッシュテーブルの衝突リスト・LRU キャッシュで同じ思考回路を使う- 計算量の見積もり — どの操作が O(1) でどれが O(n) かを体で覚える- 連結構造のバグが起きる場所 — 「片方だけ繋ぎ替えて片方を忘れる」 は実務でもよくある
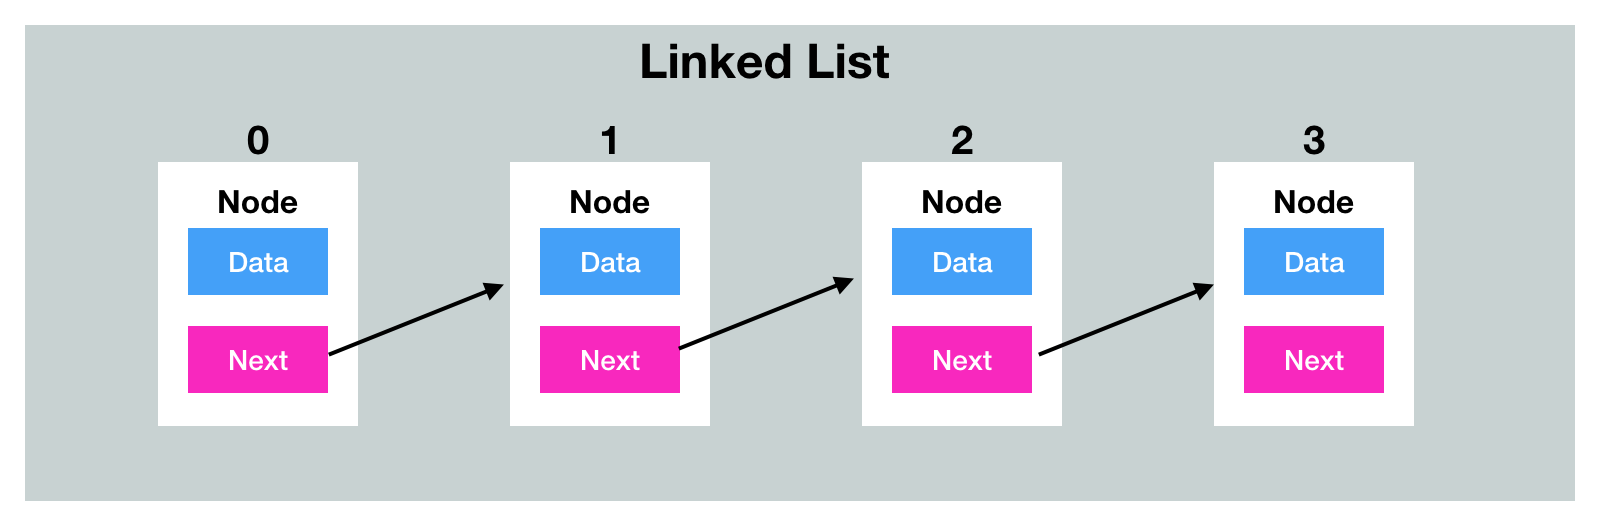
本稿では 単方向連結リスト を Generics で実装し、
java.util.LinkedListとの設計差 (双方向・サイズキャッシュ) まで言及します。
計算量サマリ (事前比較)
| 操作 | 単方向連結リスト | java.util.LinkedList (双方向) | ArrayList |
|---|---|---|---|
| 先頭追加 | O(1) | O(1) | O(n) |
| 末尾追加 | O(n) (tail を持てば O(1)) | O(1) | 均したら O(1) |
| インデックス取得 | O(n) | O(n) | O(1) |
| 要素探索 | O(n) | O(n) | O(n) |
| インデックス削除 | O(n) | O(n) | O(n) |
| キャッシュ効率 | 悪い | 悪い | 良い |
判断軸: 先頭/末尾の add/remove が多数 + ランダムアクセスなし のとき連結リスト。
インデックス参照が頻繁なら迷わず ArrayList。
Node の設計
連結リストの最小単位は Node (節)。 データ本体 + 次の Node への参照を持ちます。
final class Node<T> {
    T data;
    Node<T> next;

    Node(T data) {
        this.data = data;
    }
}
package-private + mutable に留めることで、LinkedList 側から直接書き換えやすくしています
(クライアントコードからは隠蔽するのでカプセル化は維持)。
LinkedList の実装
骨格
public final class LinkedList<T> implements Iterable<T> {
    private Node<T> head;
    private int size = 0;

    public int size() {
        return size;
    }

    public boolean isEmpty() {
        return head == null;
    }
}
size フィールドをキャッシュ しておきます。
計算してもいいが、size() が O(n) になるのは API として扱いにくいため O(1) 化。
標準の java.util.LinkedList も同じ設計です。
先頭に追加: O(1)
public void addFirst(T data) {
    Node<T> node = new Node<>(data);
    node.next = head;
    head = node;
    size++;
}
典型的な連結リストの強み。
配列ベースの ArrayList#add(0, x) は全要素のシフトで O(n) になるため、
先頭挿入が多いワークロードでは 連結リストに分があります。
末尾に追加: O(n) (tail ポインタがない実装)
public void addLast(T data) {
    Node<T> node = new Node<>(data);
    if (head == null) {
        head = node;
    } else {
        Node<T> cur = head;
        while (cur.next != null) {
            cur = cur.next;
        }
        cur.next = node;
    }
    size++;
}
末尾挿入を O(1) にしたければ tail フィールドを別途保持します。
双方向リストにすれば削除も含めて O(1) で、これが java.util.LinkedList の設計。
インデックスで取得: O(n)
public T get(int index) {
    Objects.checkIndex(index, size);
    Node<T> cur = head;
    for (int i = 0; i < index; i++) {
        cur = cur.next;
    }
    return cur.data;
}
ランダムアクセスが頻繁なら ArrayList に乗り換える合図。
要素探索: O(n)
public boolean contains(T data) {
    Node<T> cur = head;
    while (cur != null) {
        if (Objects.equals(cur.data, data)) return true;
        cur = cur.next;
    }
    return false;
}
Objects.equals を使うことで null 要素も安全に扱えます。
値指定で削除: O(n), 冪等
public boolean remove(T data) {
    if (head == null) return false;

    if (Objects.equals(head.data, data)) {
        head = head.next;
        size--;
        return true;
    }

    Node<T> prev = head;
    Node<T> cur = head.next;
    while (cur != null) {
        if (Objects.equals(cur.data, data)) {
            prev.next = cur.next;
            size--;
            return true;
        }
        prev = cur;
        cur = cur.next;
    }
    return false;
}
削除は prev → cur → next の 3 点を扱うので、どちらかを更新し忘れると壊れる のが典型バグ。
戻り値を boolean にして「見つかって削除したか」を返す API にすると、呼び出し側が条件分岐しやすくなります。
インデックス指定で削除: O(n)
public T removeAt(int index) {
    Objects.checkIndex(index, size);

    if (index == 0) {
        T removed = head.data;
        head = head.next;
        size--;
        return removed;
    }

    Node<T> prev = head;
    for (int i = 0; i < index - 1; i++) {
        prev = prev.next;
    }
    T removed = prev.next.data;
    prev.next = prev.next.next;
    size--;
    return removed;
}
Iterable 実装 (拡張 for を使えるように)
@Override
public Iterator<T> iterator() {
    return new Iterator<>() {
        private Node<T> cur = head;

        @Override public boolean hasNext() {
            return cur != null;
        }

        @Override public T next() {
            if (cur == null) throw new NoSuchElementException();
            T data = cur.data;
            cur = cur.next;
            return data;
        }
    };
}
これで Stream も使えます (StreamSupport.stream(list.spliterator(), false))。
デバッグ用 toString
@Override
public String toString() {
    StringBuilder sb = new StringBuilder("[");
    for (Node<T> cur = head; cur != null; cur = cur.next) {
        sb.append(cur.data);
        if (cur.next != null) sb.append(", ");
    }
    return sb.append("]").toString();
}
使用例
public class Main {
    public static void main(String[] args) {
        LinkedList<String> list = new LinkedList<>();
        list.addFirst("c");
        list.addFirst("b");
        list.addFirst("a");
        list.addLast("d");
        System.out.println(list);  // [a, b, c, d]

        list.remove("b");
        System.out.println(list);  // [a, c, d]

        for (String s : list) {
            System.out.println(s);
        }
    }
}
java.util.LinkedList との差分
標準の LinkedList は本稿の実装と比べて以下が強化されています:
- 双方向 (
prevフィールドも持つ) → 末尾削除も O(1)、逆方向イテレーションも可能-Deque実装 → スタック/キューとしても使える-sizeキャッシュ済- 並行変更検知 (modCount による fail-fast Iterator) ただし本家LinkedListですら、現場ではArrayListorArrayDequeに負けるケースが多数。 以下が参考になります。
現場で連結リストが勝つシーン
正直、Java 実務で連結リストが ArrayList/ArrayDeque に勝つのは次くらいです:
-
両端キューとしても使わず、純粋に先頭 add/remove だけが大量発生 する処理 →
ArrayDequeでよい- 連結リストの構造自体を使う必要がある (LRU キャッシュ、FreeList、Skiplist の内部表現など) → 連結構造を直接扱う- ノードを他データ構造と共有 する → 連結ノードを引き回すような設計 逆に以下のケースはArrayList一択: -
インデックス参照がある
-
全件イテレーションがホットループ
-
サイズが数千要素以下 (キャッシュ局所性で ArrayList が勝ちやすい)
落とし穴
1. 連結を片方だけ更新する
削除時に prev.next = cur.next と書くとき、prev 側か cur.next 側のどちらかを更新し忘れるとリークしたり、循環参照したりします。
単方向リストなら 1 ヶ所、双方向なら 4 ヶ所の更新が必要 と覚えておきましょう。
2. ループ検出なしで while(cur != null)
バグで循環リスト (A→B→A) になっていると、Iterator が無限ループに陥ります。 テストやデバッグ時に サイクル検出 (Floyd のウサギとカメ) を仕込んでおくと事故防止になります。
3. GC に優しくない削除
削除時に cur.data = null; cur.next = null と明示的に切っておくと、
参照サイクルや大きなオブジェクトの長期保持を防げます。
java.util.LinkedList#unlink も実際この処理を入れています。
まとめ: 連結リストは「現場で選ぶべきデータ構造」としての出番は限定的ですが、 ツリー・ハッシュ衝突リスト・LRU キャッシュなど 他構造の中身 として頻出します。 Node の 繋ぎ替え を手で書けることは、 他のデータ構造を実装・デバッグするための基礎体力です。
関連記事
 アルゴリズム·
二分木 (Binary Tree) を Java で自作する — BST / 走査 / バランス崩れの実例
二分木、特に二分探索木 (BST) を Generics で実装。挿入・探索・削除の計算量、3 種類の走査、偏った木がなぜ遅くなるかとその対策 (AVL / Red-Black Tree) まで。
 アルゴリズム·
FactoryMethod パターン — Spring BeanFactory の背骨を自作する
インスタンス生成の種類を抽象側に閉じ込める Factory Method パターン。JDK/Spring の実例、Simple Factory との違い、現代 Java での書き方まで。
 アルゴリズム·
TemplateMethod パターン — Spring JdbcTemplate に見る典型実装
処理の骨格は親、差分は子に書き分ける Template Method。Spring の `*Template` 系の設計思想と、Strategy / Decorator との使い分け。